엑셀에서 CSV나 TXT 파일을 열었는데 한글이 여기처럼 알 수 없는 문자로 깨져 보인 적이 있다면, 파일이 저장된 인코딩 방식과 엑셀이 읽는 방식이 달라서 생긴 문제입니다. 파워쿼리로 파일을 불러올 때 원본 인코딩을 CP949 또는 UTF-8로 맞춰 주면 대부분 바로 해결됩니다. 파일을 불러오는 단계에서 인코딩 드롭다운 메뉴만 변경하면 되며, 이미 불러온 데이터라면 파워쿼리 편집기의 파일 원본 설정에서 수정할 수 있습니다.
한글 CSV·TXT가 깨지는 이유, 인코딩 차이부터 이해하기
CSV는 텍스트 파일에 콤마(,) 같은 구분 기호로 값을 나열해 둔 형식입니다. 문제는 이 텍스트 파일이 어떤 문자 집합으로 저장됐는지에 따라 엑셀에서 보이는 결과가 달라진다는 점입니다. 우리나라에서 주로 사용하는 인코딩은 UTF-8과 CP949(ANSI, EUC-KR) 두 가지입니다.
파일을 UTF-8로 저장했는데 엑셀이 CP949로 읽으려 하면 글자가 깨져 보이고, 반대로 CP949로 저장된 파일을 UTF-8로 읽어도 같은 문제가 발생합니다. 파워쿼리에서 파일을 불러올 때 원본 파일의 인코딩을 정확히 지정하면 처음부터 깨지지 않은 상태로 데이터를 가져올 수 있습니다.
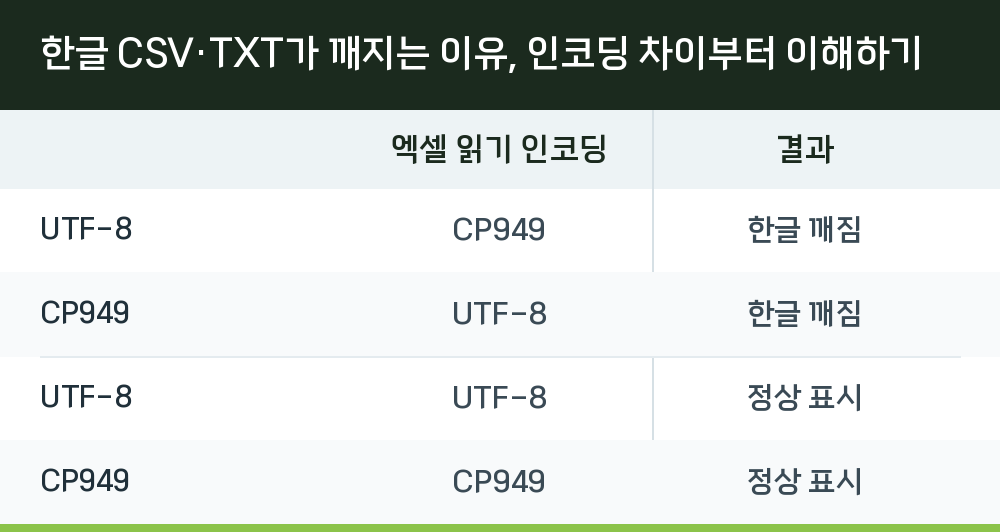
| 저장 인코딩 | 엑셀 읽기 인코딩 | 결과 |
|---|---|---|
| UTF-8 | CP949 | 한글 깨짐 |
| CP949 | UTF-8 | 한글 깨짐 |
| UTF-8 | UTF-8 | 정상 표시 |
| CP949 | CP949 | 정상 표시 |
파워쿼리 인코딩 설정, 파일 불러올 때와 불러온 후 각각 처리법
파일을 불러오는 중간에 인코딩 변경하기
엑셀에서 데이터 탭 → 텍스트/CSV에서를 선택하면 파워쿼리 창이 열립니다. 파일을 선택하면 미리보기 화면이 나타나는데, 이때 데이터가 깨져 보인다면 파일 원본 아래에 있는 인코딩 드롭다운 메뉴를 확인해야 합니다.
기본값은 UTF-8로 되어 있지만, 파일이 CP949로 저장된 경우 한국어(CP949) 또는 EUC-KR로 바꿔야 제대로 표시됩니다. 인코딩을 변경하면 미리보기 화면에 한글이 정상적으로 보이는지 바로 확인할 수 있습니다. 데이터가 올바르게 표시되면 로드 또는 변환 버튼을 눌러 다음 단계로 진행하면 됩니다.
이미 불러온 데이터의 인코딩 변경하기
파일을 불러오는 과정이 아니라 이미 파워쿼리 편집기까지 들어온 상태에서 인코딩을 변경해야 할 때도 있습니다. 이 경우 파워쿼리 편집기 왼쪽에 있는 쿼리 창에서 해당 쿼리를 선택한 뒤, 오른쪽에 있는 파일 원본 설정을 변경하면 됩니다.
홈 탭 → 데이터 원본 설정 → 원본 변경을 선택하면 인코딩과 구분 기호를 다시 지정할 수 있는 창이 열립니다. 여기서 파일 원본을 변경하면 미리보기 데이터가 즉시 갱신되므로, 한글이 정상적으로 보이는 인코딩을 찾을 때까지 몇 번 시도해 볼 수 있습니다.
파일 자체가 손상됐는지 확인하는 방법
인코딩 설정을 바꿔도 해결되지 않는 경우가 있습니다. 이때는 파일 자체가 손상됐을 가능성을 의심해 봐야 합니다. 메모장으로 해당 파일을 열어 확인하는 방법이 가장 빠릅니다.
메모장에서 파일 → 다른 이름으로 저장을 클릭하면 하단에 인코딩 항목이 표시됩니다. 여기에 UTF-8이라고 적혀 있으면 UTF-8 파일, ANSI라고 적혀 있으면 CP949 계열 파일입니다. 메모장에서도 한글이 깨져 보인다면 파일이 손상된 상태이므로 원본 파일을 다시 받아야 합니다.
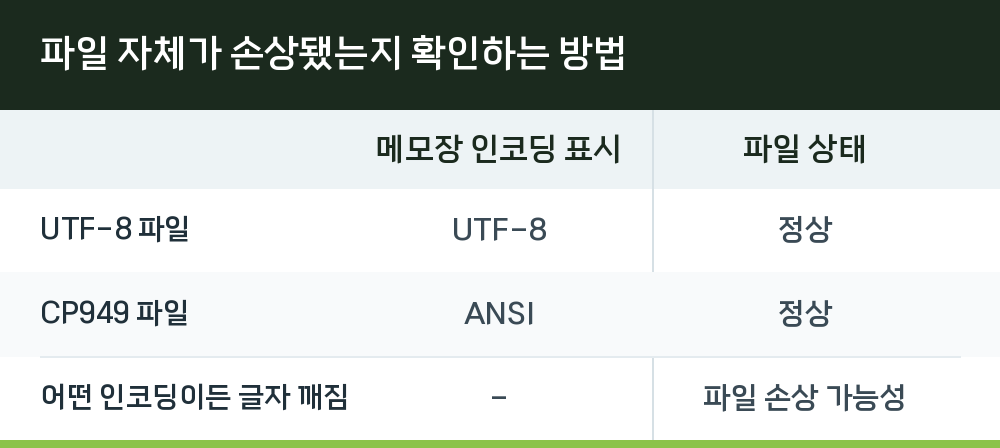
| 구분 | 메모장 인코딩 표시 | 파일 상태 |
|---|---|---|
| UTF-8 파일 | UTF-8 | 정상 |
| CP949 파일 | ANSI | 정상 |
| 어떤 인코딩이든 글자 깨짐 | - | 파일 손상 가능성 |
인코딩 외에 확인해야 할 구분 기호 설정
한글이 정상적으로 표시되는데 데이터가 한 개의 열로만 들어오는 경우가 있습니다. 이는 파일의 구분 기호가 기본값인 쉼표(,)가 아니라 세미콜론(;)이나 탭으로 되어 있기 때문입니다.
파워쿼리에서 파일을 불러올 때 구분 기호 항목이 기본값인 쉼표로 되어 있는데, 실제 파일이 세미콜론으로 구분되어 있다면 데이터가 분리되지 않고 한 열에 모두 들어오게 됩니다. 이 경우 구분 기호를 세미콜론이나 사용자 지정으로 변경하면 데이터가 여러 열로 나뉘어 표시됩니다. 메모장에서 파일을 열어 보면 쉼표나 세미콜론이 어디에 위치해 있는지 바로 확인할 수 있습니다.
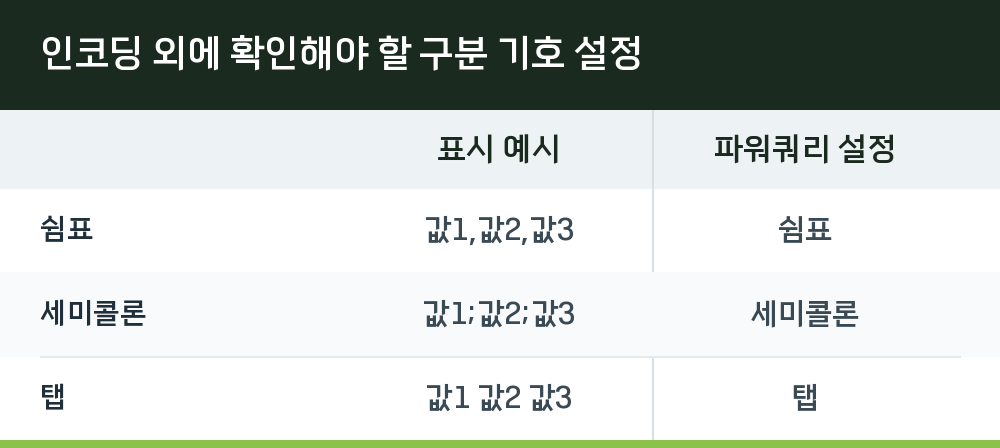
| 구분 기호 | 표시 예시 | 파워쿼리 설정 |
|---|---|---|
| 쉼표 | 값1,값2,값3 | 쉼표 |
| 세미콜론 | 값1;값2;값3 | 세미콜론 |
| 탭 | 값1 값2 값3 | 탭 |
숫자처럼 보이는 코드가 날짜나 숫자로 바뀌는 문제
검사 성적서나 설비 데이터처럼 코드와 측정값이 섞인 CSV 파일은 인코딩 문제와 별개로 또 다른 오류가 발생할 수 있습니다. 1-2가 날짜로 바뀌거나, 00125의 앞자리 0이 사라지고, 10E-3이 숫자로 해석되는 경우입니다.
이미 엑셀이 원본 문자열을 날짜나 숫자로 해석해 저장한 뒤라면 표시 형식을 텍스트로 바꿔도 원래 값이 완전히 복구되지 않을 수 있습니다. CSV 파일을 더블클릭으로 바로 열지 말고, 파워쿼리를 통해 열별로 자료형을 먼저 지정하는 것이 안전합니다.
게이지 ID, LOT 번호, 시리얼 번호, 측정 포인트 코드처럼 숫자 모양이어도 계산 대상이 아닌 값은 텍스트형으로 가져와야 합니다. 반대로 실측값, 공차 상한·하한, 기준값처럼 SPC나 합불 판정에 사용되는 값은 숫자형으로 변환해야 합니다.
한글이 포함된 CSV 파일 저장 시 주의할 점
파워쿼리로 불러오는 방법도 중요하지만, 애초에 CSV 파일을 저장할 때 한글이 깨지지 않도록 저장하는 것도 실무에서 자주 필요한 작업입니다. 엑셀에서 파일 → 다른 이름으로 저장을 선택할 때 파일 형식을 CSV UTF-8(쉼표로 분리)로 선택하면 한글이 포함된 데이터도 다른 프로그램에서 깨지지 않습니다.
다만 일부 오래된 시스템이나 프로그램이 CP949만 지원하는 경우에는 UTF-8로 저장된 파일을 인식하지 못할 수 있습니다. 이 경우에는 상대방 시스템에 맞춰 CSV(쉼표로 분리) 형식으로 저장해서 보내야 합니다. 받는 쪽에서 사용하는 프로그램이 무엇인지 확인한 뒤 저장 방식을 결정하는 것이 좋습니다.
Q. 메모장에서 인코딩을 확인하는 방법이 궁금해요.
메모장에서 파일을 연 뒤 파일 → 다른 이름으로 저장을 클릭하면 하단에 인코딩 항목이 보입니다. UTF-8로 표시되면 UTF-8 파일, ANSI로 표시되면 CP949 계열 파일입니다.
Q. 파워쿼리 편집기에서 인코딩을 바꿨는데도 한글이 깨져 보여요.
파일 자체가 손상됐을 가능성이 있습니다. 메모장에서 해당 파일을 열어 한글이 정상적으로 보이는지 확인해 보세요. 메모장에서도 깨져 보인다면 원본 파일을 다시 받아야 합니다.
Q. CSV 파일을 불러왔는데 모든 데이터가 한 열에 들어와요.
파일의 구분 기호가 쉼표가 아니라 세미콜론이나 탭으로 되어 있을 수 있습니다. 파워쿼리에서 구분 기호를 세미콜론이나 사용자 지정으로 변경하면 여러 열로 나뉘어 표시됩니다.